Test t de Student

Effectuez des tests d'hypothèse pour déterminer si des moyennes diffèrent significativement.

Chargement de la simulation interactive...

ce que p < 0.05 signifie vraiment 🖖

La valeur p est la probabilité d'observer une statistique de test au moins aussi extrême que la vôtre, en supposant que H₀ est vraie. Ce N'EST PAS la probabilité que H₀ soit vraie. Une valeur p de 0.03 signifie : si l'hypothèse nulle était vraie, vous observeriez un résultat aussi extrême seulement 3 % du temps par hasard — assez inhabituel pour la rejeter. Mais un seuil de signification de 5 % signifie que 1 test sur 20 rejettera à tort une hypothèse nulle vraie, uniquement par hasard (erreur de type I). Un α plus petit est plus strict, mais augmente les erreurs de type II (effets réels non détectés). Le graphique le montre directement : si la ligne rouge dépasse le seuil ambré, alors p < α.

Un rapport signal/bruit pour les moyennes 🖖

Au fond, la statistique t n'est qu'un rapport signal/bruit : l'écart entre les moyennes des groupes (le signal) divisé par l'erreur standard (le bruit dû à l'échantillonnage aléatoire). Un grand t signifie que la différence se détache nettement de la dispersion ; un petit t pourrait aisément relever du hasard. La leçon pratique : un même écart de moyennes devient plus convaincant à mesure que les échantillons grandissent ou que leur dispersion diminue, car cela réduit le bruit au dénominateur.

Les degrés de liberté de Welch ne sont pas entiers 🖖

On s'attendrait à ce que les degrés de liberté soient un entier bien net — le nombre d'informations indépendantes. Pourtant le test t de Welch emploie la formule de Welch-Satterthwaite, qui renvoie généralement une valeur fractionnaire comme df = 17.4. C'est une approximation délibérée : quand les variances sont inégales, aucun df entier exact n'existe, alors la méthode interpole pour coller au plus près à la vraie distribution. Voilà pourquoi le df de Welch diffère souvent du classique n₁ + n₂ − 2.

LE TEST t — QUEL PLAN, ET QUE DIT VRAIMENT LE VERDICT ?

Dans quel cas du test t êtes-vous ?

Deux questions décident de tout ici. D’abord le plan : comparez-vous un groupe à une valeur annoncée, ou deux groupes entre eux ? Cela fixe la formule et les degrés de liberté. Ensuite la lecture : un petit p rejette l’hypothèse nulle, mais un grand p ne la démontre pas — le plus souvent, il signale seulement un échantillon trop petit pour trancher. Ces deux erreurs sont plus fréquentes que les fautes de calcul.

Un échantillon contre une valeur annoncée — la preuve passe la barre t = (x̄ − μ₀) / (s/√n)
Un écart plus petit — pas de verdict, ce qui n’est pas « pas d’effet » p > α ⇏ H₀
Deux groupes indépendants — Welch, sans hypothèse d’égalité des variances SE = √(s₁²/n₁ + s₂²/n₂)
La même comparaison, sous-dimensionnée — un écart que l’échantillon ne résout pas 1 − β ∝ δ√n/s

01

Un échantillon contre une valeur annoncée — la preuve passe la barre

Ce que vous savez: Un groupe de mesures et un nombre auquel les confronter. La statistique vaut t = (x̄ − μ₀)/(s/√n) à n − 1 degrés de liberté.

Statistique: t = (x̄ − μ₀) / (s/√n)

Exemple résolu: x̄ = 78 contre μ₀ = 72 avec s = 8 et n = 30 → SE = 1,461, t = 4,108, df = 29, p = 0,0003

Ouvrir ce cas: Examen (rejette H₀)
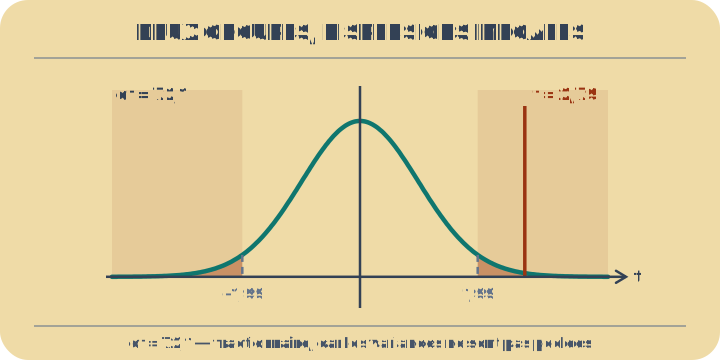
Un échantillon contre une valeur annoncée — la preuve passe la barre. Le t observé tombe bien au-delà des valeurs critiques, au cœur de la zone de rejet grisée. Un groupe de mesures et un nombre auquel les confronter. La statistique vaut t = (x̄ − μ₀)/(s/√n) à n − 1 degrés de liberté.
Le t observé tombe bien au-delà des valeurs critiques, au cœur de la zone de rejet grisée.

02

Un écart plus petit — pas de verdict, ce qui n’est pas « pas d’effet »

Ce que vous savez: Même plan, même n, mais l’écart est faible devant le bruit. p dépasse α, l’hypothèse nulle n’est donc pas rejetée.

Statistique: p > α ⇏ H₀

Exemple résolu: x̄ = 73 contre μ₀ = 72 avec s = 8 et n = 30 → t = 0,685, p = 0,499

Ouvrir ce cas: Examen (ne rejette pas)
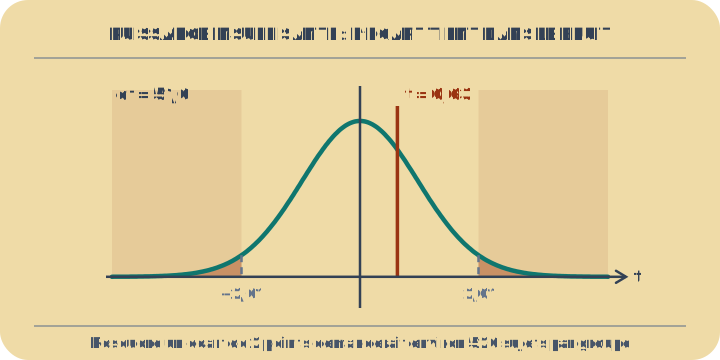
Un écart plus petit — pas de verdict, ce qui n’est pas « pas d’effet ». Le t observé se place entre les valeurs critiques, là où le test ne peut trancher ni dans un sens ni dans l’autre. Même plan, même n, mais l’écart est faible devant le bruit. p dépasse α, l’hypothèse nulle n’est donc pas rejetée.
Le t observé se place entre les valeurs critiques, là où le test ne peut trancher ni dans un sens ni dans l’autre.

03

Deux groupes indépendants — Welch, sans hypothèse d’égalité des variances

Ce que vous savez: Deux échantillons distincts, chacun avec sa moyenne, sa dispersion et sa taille. SE = √(s₁²/n₁ + s₂²/n₂), et les degrés de liberté sortent fractionnaires.

Statistique: SE = √(s₁²/n₁ + s₂²/n₂)

Exemple résolu: 82 ± 10 sur 40 sujets contre 75 ± 12 sur 38 → SE = 2,508, t = 2,791, df = 72,1, p = 0,0067

Ouvrir ce cas: Essai clinique (sign.)
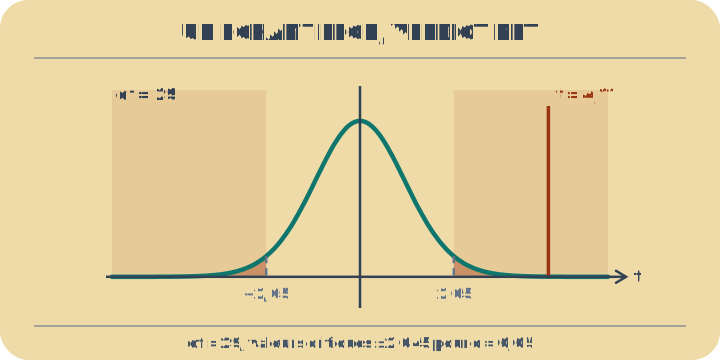
Deux groupes indépendants — Welch, sans hypothèse d’égalité des variances. Deux dispersions, deux effectifs et un df qui n’est pas entier : la signature de Welch. Deux échantillons distincts, chacun avec sa moyenne, sa dispersion et sa taille. SE = √(s₁²/n₁ + s₂²/n₂), et les degrés de liberté sortent fractionnaires.
Deux dispersions, deux effectifs et un df qui n’est pas entier : la signature de Welch.

04

La même comparaison, sous-dimensionnée — un écart que l’échantillon ne résout pas

Ce que vous savez: Deux groupes de nouveau, mais plus petits et plus proches l’un de l’autre. Le résultat ne se distingue pas du bruit.

Statistique: 1 − β ∝ δ√n/s

Exemple résolu: 77 ± 11 sur 25 sujets contre 75 ± 12 sur 28 → SE = 3,160, t = 0,633, df = 51,0, p = 0,530

Ouvrir ce cas: Essai clinique (non sign.)
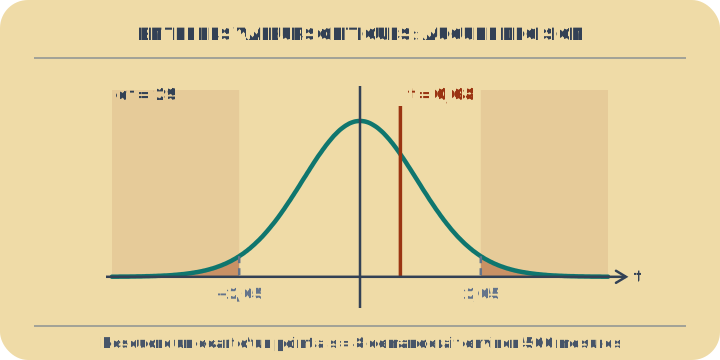
La même comparaison, sous-dimensionnée — un écart que l’échantillon ne résout pas. Le t observé se place presque au centre de la distribution, là où réside presque toute la probabilité. Deux groupes de nouveau, mais plus petits et plus proches l’un de l’autre. Le résultat ne se distingue pas du bruit.
Le t observé se place presque au centre de la distribution, là où réside presque toute la probabilité.

Problème entièrement résolu

  1. Un échantillon de 30 obtenant 78 là où la moyenne de la population est 72 5 étapes

    Un échantillon de 30 obtient une moyenne de 78 là où la moyenne de la population annoncée est de 72, avec s = 8. Effectuez le test — puis répondez à la question à laquelle la p-valeur ne répond pas.

    1. Une seule moyenne est une estimation bruitée, et son bruit est l'erreur type — la dispersion de l'échantillon divisée par la racine de la taille de l'échantillon. Des échantillons plus grands ne rendent pas les individus moins variables ; ils rendent la moyenne moins variable.

    2. La statistique t cherche à savoir combien d'erreurs types séparent ce que vous avez observé de ce qui était annoncé. C'est une distance mesurée en unités de sa propre incertitude.

    3. Les degrés de liberté sont inférieurs d'une unité à la taille de l'échantillon, car la moyenne de l'échantillon a déjà été consommée pour estimer le centre. Le calculateur ci-dessus affiche cela ainsi que la statistique.

    4. La p-valeur est la probabilité d'obtenir un |t| aussi grand si l'affirmation était vraie. L'outil affiche 0.0002982 — soit environ 3 sur 10 000.

    5. Voici maintenant la partie sur laquelle la p-valeur reste muette : à quel point la différence est grande. Le d de Cohen divise par la dispersion des données plutôt que par la dispersion de la moyenne, et ne diminue donc pas à mesure que l'échantillon grandit.

    Réponse

    t = 4.1079 sur 29 df, p = 0.0002982. La taille d'effet est d = 0.75, une différence réellement grande. Les distinguer constitue toute la discipline : p répond à « cela pourrait-il être du bruit ? », et peut être rendu arbitrairement petit en collectant plus de données, car n apparaît dans l'erreur type. d répond à « cela a-t-il de l'importance ? », et ne varie pas avec n. Une étude avec n = 10 000 peut rapporter p < 0.001 pour un d de 0.02 — statistiquement certain, pratiquement négligeable.

Parcours

Quand une différence est-elle réelle ?

Références (1)